
「あの規程はどこに保存されていたっけ?」
社内文書を探すたびにフォルダを掘り返し、結局は詳しい先輩に聞いてしまう。
そんな経験はありませんか。
文書が増えるほど「検索しても目的の資料にたどり着けない」という悩みは深刻になります。
実際、AI導入支援の現場で最初にヒアリングすると、多くの企業で「探す時間」と「聞かれる時間」の両方が負担になっているのが実情です。
この課題を根本から解決する手段として注目されているのが、生成AIを活用した社内文書検索です。
キーワードを正確に思い出せなくても、自然な文章で質問するだけで関連文書を探し、要点まで回答してくれます。
この記事でわかること
生成AIによる社内文書検索の仕組み(RAGとは何か)
導入するメリットと、見落としがちな注意点・リスク対策
みずほ証券・京都銀行など最新の導入事例と定量的な成果
失敗しない導入手順と、自社に合ったサービスの選び方
生成AIによる社内文書検索とは?「探しても見つからない」を解決する仕組み
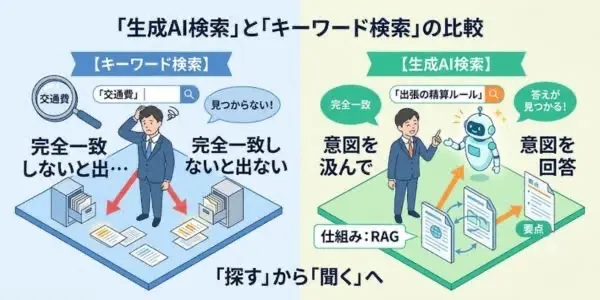
生成AIによる社内文書検索とは、社内の規程・マニュアル・議事録などを対象に、自然な質問文で関連情報を探し出し、要点を根拠付きで回答する仕組みです。
従来のキーワード検索と違い、「正しい検索語」を知らなくても目的の情報にたどり着けるのが最大の特長です。
従来のキーワード検索の限界
従来の文書検索は、入力した単語と文書内の語句がどれだけ一致するかで結果を出します。そのため、適切なキーワードを知らないと必要な情報にたどり着けません。
例えば「出張の交通費精算」を調べたいのに、社内文書では「旅費規程」と表現されている。
この“言葉のズレ”が検索失敗の典型パターンです。
結果として、情報が特定の人に集中する属人化や、問い合わせ対応の工数増加を招きます。
導入前のヒアリングで「経費のルールは毎回総務に電話して確認していた」という声が複数部署から挙がったというケースもありました。
生成AI検索でできること
生成AIを使った文書検索では、主に次の3つが実現できます。
セマンティック検索:キーワードの意味や文脈を理解し、言い換え・表現ゆれも拾う
自動要約:数十ページの資料から核心部分だけを抽出して提示
根拠付き質疑応答:質問に対し、参照元の文書名やページまで示して回答
仕組みの中核「RAG(検索拡張生成)」
この回答生成を支えているのがRAG(Retrieval-Augmented Generation:検索拡張生成)という技術です。
生成AIが社内文書を検索し、その内容を根拠にして回答を組み立てる仕組みで、詳しくは次章で解説します。
生成AIとRAGは何が違う?精度を左右する仕組みを理解する
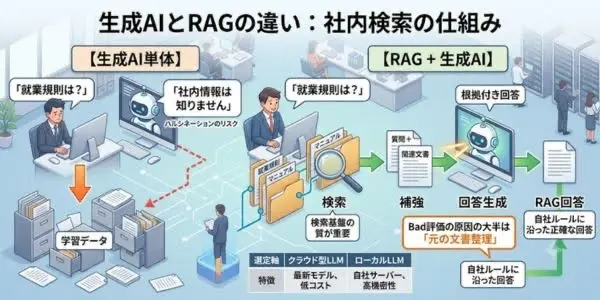
生成AI単体は、学習していない社内固有の情報には答えられません。
RAGは社内文書を検索してその内容を根拠に回答するため、自社ルールに沿った正確な回答が可能になります。
つまりRAGは、生成AIを“社内の物知り”に変えるための仕組みです。
生成AI単体では社内情報に答えられない理由
ChatGPTのような生成AIは、公開データを学習しています。
しかし、あなたの会社の就業規則や独自マニュアルは学習していません。
そのため社内情報をそのまま質問すると、それらしく見えて実は誤っている回答(ハルシネーション)を返すリスクがあります。
ここが、生成AIを社内文書検索にそのまま使えない理由です。
RAGの処理フローと、精度を決める3要素
RAGは、
「①質問に関連する文書を検索(Retrieval)→ ②検索結果で質問を補強(Augmented)→ ③根拠に基づき回答を生成(Generation)」
という流れで動きます。
重要なのは、RAGの回答精度は生成AIの賢さよりも「検索基盤の質」で決まるという点。
実際、キヤノンITソリューションズの導入レポートでは、RAGのBad評価の原因の内訳は、「文書の不備・不足が46%」「検索精度の低さが42%」で、生成AIの精度が原因だったケースはわずか12%にとどまったと報告されています(出典:キヤノンITソリューションズ テクニカルレポート)。
精度を左右する主な要素は次の3つです。
要素 | 内容 | 実務上のポイント |
|---|---|---|
チャンク設計 | 文書を検索単位に分割する方法 | 細かすぎると文脈が切れ、粗すぎるとノイズが増える |
メタデータ | 文書名・部署・更新日などのタグ | 付与するほど絞り込み精度が上がる |
ハイブリッド検索 | キーワード検索+セマンティック検索の併用 | 社内用語・型番と言い換えの両方に強くなる |
「精度が出ない」と相談された案件のほとんどは、AIの性能ではなく“元の文書が整理されていない”ことが原因だったという事例もあります。
ローカルLLM と クラウド型LLM の違い(情報漏えい対策の観点)
「機密文書を外部に出したくない」という不安には、ローカルLLM(自社サーバー内で動かす大規模言語モデル)という選択肢があります。
データを社外に出しにくい構成を取れるため、金融・医療など機密性の高い業界で注目されています。
一方、クラウド型は初期構築が速く、最新モデルを低コストで使えるのが利点です。
どちらが正解ということはなく、扱う情報の機密度とコストのバランスで選びます。
生成AIで社内文書検索を導入する4つのメリット
生成AI社内文書検索の導入効果は、
①検索時間の削減
②属人化の解消
③意思決定の質向上
④問い合わせ対応の自動化
この4つに集約されます。
単なる時短ツールではなく、組織のナレッジ活用そのものを底上げする施策です。
1. 検索・問い合わせ時間の大幅削減
最も直接的な効果が時間削減です。
後述する事例では、社内ルールの検索・問い合わせ時間を大幅に削減した企業が複数あります。
「探す時間」と「聞かれる時間」の両方が減るのがポイントです。
2. ナレッジの属人化解消
「あの案件は○○さんしか知らない」という状態は、担当者の異動・退職で一気にリスク化します。
文書が“検索可能な資産”に変わることで、誰もが同じ情報にアクセスできる環境が整います。
3. 根拠提示による意思決定の質向上
RAGは回答の参照元を示せるため、「この規程のこの条項に基づく」と根拠をたどれます。
思い込みや古い情報での判断を防ぎ、意思決定の質が上がります。
議事録をAIに検索させ、「あの決定はいつ・なぜ下されたか」を数秒で遡れるようにしたところ、会議の“蒸し返し”が目に見えて減ったという事例もあります。
導入検討の第一歩として、「月に何時間、文書を探す・聞かれることに費やしているか」を部署ごとにざっくり試算してみましょう。 投資対効果の説明材料になります。
社内データをAIで活用する全体像を知りたい方は、社内データAI分析の導入完全ガイドもあわせてご覧ください。
導入前に知るべき注意点とリスク対策
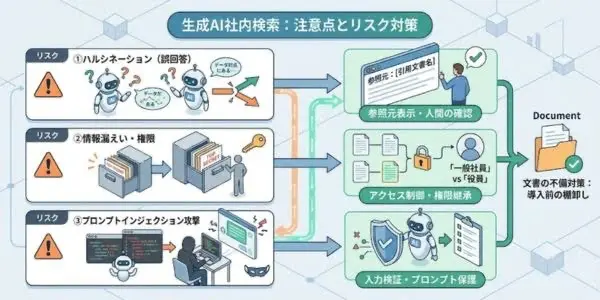
生成AI社内文書検索の主なリスクは、
①ハルシネーション(誤回答)
②情報漏えい・権限の問題
③プロンプトインジェクション攻撃
この3つです。
いずれも対策とセットで設計すれば十分にコントロール可能で、“怖いから使わない”のは機会損失になります。
1. ハルシネーション(誤回答)と対策
生成AIは、事実と異なる回答をもっともらしく返すことがあります。
これを鵜呑みにすると意思決定を誤りかねません。
対策としては
①回答に必ず参照元(引用)を表示させる
②「AIは間違えることがある」という前提を社員に周知する
③重要な判断は人間が最終確認する
という3点です。
参照元が示されれば、利用者自身が正誤を検証できます。
2. 情報漏えい・権限(アクセス制御)の設計
社内文書を扱う以上、「誰がどの文書にアクセスできるか」の設計は必須です。
権限設計を誤ると、閲覧権限のない社員に機密情報が回答されてしまう恐れがあります。
対策として、社内認証基盤と連携し、利用者が閲覧を許可された文書のみから回答する仕組みを導入します。
これはキヤノンITソリューションズの事例でも実装されている、実務上の重要ポイントです。
権限設計を後回しにしてPoCを進めた結果、本番移行直前に「役員文書が一般社員にヒットする」問題が発覚し、大きな手戻りになったケースもあるため十分に注意が必要です。
3. プロンプトインジェクション攻撃への防御
これは、悪意ある指示文をAIに読み込ませて誤作動させる攻撃手法です。
文書内に紛れ込んだ不正な指示にAIが従ってしまうリスクがあります。
入力の検証や、システムプロンプトの保護といった対策が必要です。
【リスク対策チェックリスト】
リスク | 主な対策 |
|---|---|
ハルシネーション | 引用元の必須表示・人間の最終確認 |
情報漏えい | 権限継承・機密マスキング・監査ログ |
インジェクション | 入力検証・システムプロンプト保護 |
文書の不備 | 導入前の文書棚卸し・版管理の整備 |
生成AI社内文書検索の導入支援・おすすめサービス比較
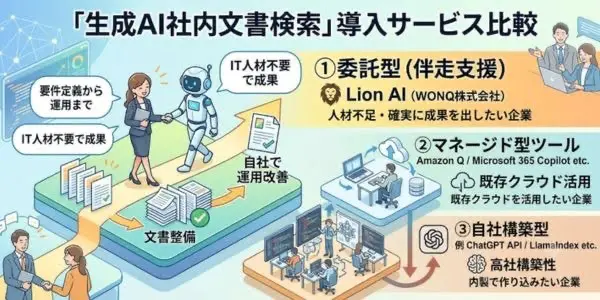
自社に合う選択肢は、3タイプに分かれます。
①委託型(伴走支援)
②マネージド型ツール
③自社構築型
IT人材が不足していて「要件定義から運用まで任せたい」企業には委託型、既存のクラウド環境を活かしたい企業にはマネージド型が向きます。
1. Lion AI(WONQ株式会社)|導入から運用まで一気通貫で伴走
「まずは小さく自動化したい」
「効率化に取り組みたいけど、どこから始めればいいかわからない」
こうした企業にまず検討してほしいのがAI導入コンサルのLion AI(ライオンAI)です。
最大の強みは、要件定義・文書整備・システム構築・評価改善まで一気通貫で伴走する体制にあります。
社内文書検索は前章の通り「文書の整備」で成否が決まるため、ツールを渡すだけでなく“成果が出る状態”まで支援できるかが重要です。
専任のIT担当がいない企業でも、内製化まで見据えて進められる点が委託型の価値です。
Lion AIのような伴走型支援では、単なる納品で終わらず「自社で運用改善を回せる状態」まで引き上げられるため、導入後の形骸化を防ぎやすいです。
AI導入そのものの進め方に不安がある方は、AI導入コンサルティングおすすめ比較|費用相場と失敗しない選び方を専門家が解説も参考にしてみてください。
2. マネージド型ツール(Amazon Q Business / Microsoft 365 Copilot 等)
すでにクラウド環境(AWS・Microsoft 365)を使っている企業には、マネージド型が有力です。
既存のデータやアカウント権限と連携しやすく、比較的短期間で立ち上げられます。
3. 自社構築型(ChatGPT API / LlamaIndex 等)
AI人材が社内にいて、要件を細かく作り込みたい企業向けです。
自由度が高い反面、チャンク設計や評価の仕組みまで自前で用意する必要があり、難易度は最も高くなります。
【タイプ別比較表】
選定軸 | ①委託型(Lion AI等) | ②マネージド型 | ③自社構築型 |
|---|---|---|---|
導入スピード | 中(伴走で確実) | 速い | 遅い |
自由度 | 高(要件に合わせ設計) | 中 | 最高 |
必要な社内人材 | 少なくてOK | 中程度 | 多い(AI人材必須) |
文書整備の支援 | ○ 含む | △ 自社対応 | × 自社対応 |
おすすめ企業 | AI人材が不足・確実に成果を出したい | 既存クラウドを活用したい | 内製で作り込みたい |
まずは「社内にAIを設計・運用できる人材がいるか」を基準に3タイプから絞り込みましょう。
人材が不足しているなら、文書整備まで支援する委託型が失敗リスクを最も抑えられます。
生成AIで社内文書検索を実現した企業の導入事例
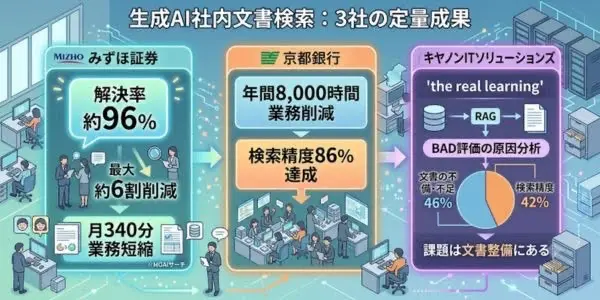
大手企業ではすでに定量的な成果が出ています。
ここでは、解決率・削減時間といった具体的な数字が公表されている3つの事例を紹介します。
事例1:みずほ証券「MOAIサーチ」——解決率96%・月340分削減
みずほ証券は、約4,000件を超える社内文書を横断検索できるシステム「MOAIサーチ」を内製開発し、現在は業務での本番利用が進み、利用する社員数も増加しています。
解決率 約96%
社内ルールの検索・問い合わせ業務時間を最大約6割(1人あたり約340分/月)削減
ユーザーテストで約98%が「継続して使いたい」と回答
(出典:みずほフィナンシャルグループ 公式サイト)
特定領域に絞らず全領域の文書を対象にした点が特長で、グループ内でも先進事例として注目されました。
事例2:京都銀行——年間8,000時間の削減見込み
京都銀行は2025年2月、AIチャットボットに生成AIの文書検索・回答生成機能を追加し、全従業員約4,300人を対象に活用を開始しました。
年間8,000時間の業務削減を見込む
実証実験で検索精度86%を達成
行員の約9割が導入を希望
(出典:PKSHA Technology/日経クロステック等)
1日平均400件の照会対応と、その裏にあったFAQ登録の負荷を軽減した実務的な事例です。
事例3:キヤノンITソリューションズ——精度改善の“リアル”
同社はRAGを社内サポートセンターに試験導入し、Bad評価の原因を分析。
前述の通り「文書の不備・不足46%」「検索精度42%」と、課題の大半が文書側にあることをデータで明らかにしています。
成果だけでなく、導入のリアルな学びが得られる貴重な事例です。
同規模の企業に導入支援を行うと、みずほ証券や京都銀行ほどの規模でなくても「問い合わせ工数が体感で半減した」という声は多く聞かれています。
生成AI社内文書検索の導入手順【5ステップ】
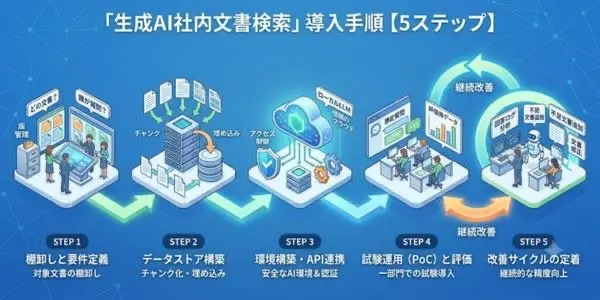
導入の成否は、システム構築よりも「事前準備」で決まります。
ここでは、実際の支援現場で用いている5ステップを紹介します。
この順序を守ることが、精度と定着の両立につながります。
STEP1:対象文書の棚卸しと要件定義
まず「どの文書を対象にするか」「誰がどんな質問をするか」を洗い出します。
ここで版管理(古い版の削除・最新版の特定)まで整えておくことが、後の精度を大きく左右します。
STEP2:データストア(チャンク化・埋め込み)の構築
社内文書を一カ所に集め、AIが検索しやすい形に整理します。
文書を適切な単位に分割(チャンク化)し、意味をベクトル化(埋め込み)して検索基盤を作る工程です。
STEP3:環境構築・API連携
生成AIを安全に使える環境を整えます。
信頼できるクラウド、またはローカルLLMを選び、既存の認証基盤・権限と連携させます。ここでアクセス制御を確実に設計します。
STEP4:試験運用(PoC)と評価
いきなり全社公開せず、一部門でPoC(試験導入)を行います。
この段階で「評価用の想定質問リスト」を用意しておくと、精度の良し悪しを客観的に測れます。
PoC開始前に現場から“よく聞かれる質問”を30問集めておいたことで、公開後のクレームを事前に潰せたというケースもあります。
STEP5:改善サイクルの定着
「導入して終わり」になることは、最大の失敗パターンです。
回答ログを分析し、不足文書の追加・文書の修正を継続します。
前述のキヤノンITSの事例が示す通り、精度向上の鍵は文書の継続的な改善にあります。
ステップ | 主なアクション | つまずきやすい点 |
|---|---|---|
STEP1 | 文書棚卸し・要件定義 | 版管理の放置 |
STEP2 | チャンク化・埋め込み | 分割単位の設計ミス |
STEP3 | 環境構築・権限連携 | アクセス制御の後回し |
STEP4 | PoC・評価 | 評価基準の欠如 |
STEP5 | 改善サイクル | 運用体制の未整備 |
STEP1の「文書棚卸し」は今日から着手できます。
まず、対象候補の文書を一覧化し、“最新版がどれか判別できない文書”に印をつけてみましょう。
導入の全体像をさらに深く知りたい方は、社内データAI分析の導入完全ガイドも参考にしてみて下さい。
【2026年の最新動向】RAGから「検索エージェント」へ
2026年に入り、社内文書検索は単純なRAGから一歩進み、AIが自律的に検索と評価を繰り返す「検索エージェント(AIエージェント)」型へと進化しています。
導入を検討するなら、この流れを前提に選定するのがおすすめです。
従来のRAGは「1回検索して回答する」のが基本でした。
一方、検索エージェントは、最初の検索結果が不十分だと判断すれば、AI自身が検索条件を変えて再検索し、複数文書を突き合わせて回答を組み立てます。
これにより、複雑な質問や複数文書にまたがる質問への精度が高まります。
実際、Google Cloudが公開した国内120社以上の生成AI活用事例でも、情報を「探し、整理し、次の処理までつなげる」AIエージェント型の活用が目立ち始めています(出典:Google Cloud 生成AI活用事例/2026年)。
最近の導入相談では「単なる検索で終わらせず、見つけた情報を要約・整理まで自動化したい」というエージェント志向のニーズが増えています。
まとめ
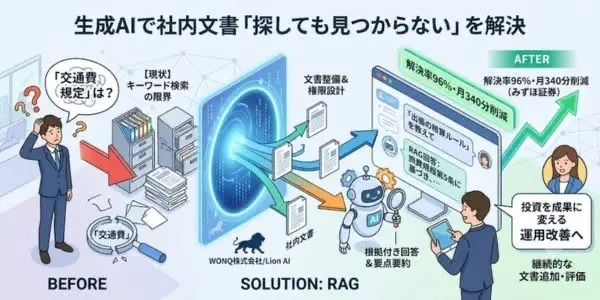
生成AIによる社内文書検索は、「探しても見つからない」という長年の課題を根本から解決する仕組みです。
中核技術のRAGを使えば、自然な質問文で根拠付きの回答が得られ、みずほ証券や京都銀行のように具体的な時間削減効果も出ています。
一方で、成功の鍵は「AIの性能」ではなく「文書の整備」と「権限設計」にあります。
ハルシネーションや情報漏えいのリスクも、対策とセットで設計すれば十分にコントロール可能です。
そして最も避けたいのは、「導入して終わり」にしてしまうこと。
文書整備から運用改善まで見据えて進めることが、投資を成果に変える唯一の道です。
2026年はRAGから検索エージェントへと技術が進化しており、これから導入するなら最新の潮流も踏まえて基盤を選ぶことをおすすめします。
自社での進め方に不安がある場合は、要件定義から運用改善まで一気通貫で伴走できる支援サービスの活用が近道です。
まずは自社の文書を棚卸しし、Lion AIの導入相談で「何から始めるべきか」を相談してみることをおすすめします。
よくある質問(FAQ)
Q1. 生成AIとRAGの違いは何ですか?
生成AIは学習済みの知識で回答する仕組みで、社内固有の情報には対応できません。
RAG(検索拡張生成)は、社内文書を検索してその内容を根拠に回答するため、自社ルールに沿った正確な回答が可能になります。
社内文書検索には、生成AIにRAGを組み合わせるのが一般的です。
Q2. 社内文書検索AIは情報漏えいの心配はありませんか?
対策を講じれば十分にコントロールできます。
具体的には、社内認証基盤と連携して閲覧権限のある文書のみを回答対象にする、機密情報を扱う場合は自社サーバー内で動かすローカルLLMを選ぶ、といった方法があります。
権限設計は導入の最初に固めておくことが重要です。
Q3. 無料で社内文書検索システムは作れますか?
技術的にはオープンソースのツールとAPIを組み合わせれば低コストで試作できますが、権限設計・文書整備・精度評価まで含めると相応の工数が必要です。
まずは小規模なPoC(試験導入)から始め、効果を確認してから本格投資する進め方が現実的です。
Q4. 導入にはどれくらいの費用・期間がかかりますか?
対象文書の量、導入形態(委託型・マネージド型・自社構築型)、必要なセキュリティ要件によって大きく変わります。
マネージド型なら比較的短期間で立ち上がり、自社構築型は数か月規模になることもあります。
まずは要件を整理し、複数の支援会社に見積もりを取ることをおすすめします。
Q5. 回答の精度(正答率)はどのくらい出ますか?
整備状況によりますが、みずほ証券では解決率約96%、京都銀行では検索精度86%という実績が公表されています。
ただし精度は文書の整備状況に大きく左右され、文書の不備・不足が誤回答の主因になることが各社の事例で示されています。
Q6. 社内にAI人材がいなくても導入できますか?
可能です。
要件定義から文書整備・構築・運用改善まで伴走してくれる委託型の支援サービスを使えば、専任のIT担当がいない企業でも導入・内製化まで進められます。
Q7. 導入して精度が出ない場合、何を見直せばよいですか?
まず疑うべきはAIの性能ではなく「文書側」です。
対象文書に必要な情報が記載されているか、古い版が混在していないか、チャンク(分割)の設計が適切かを順に確認します。
実際、誤回答の原因の多くは文書の不備・不足にあります。
 あい
SEO/Webライター Webライター歴7年。SEOライティングをはじめ、シナリオライティングやコラム執筆、広告台本ライターとしての活動経験あり。直近1年間ではライフスタイルやIT、美容など様々なジャンルで100記事以上を執筆。普段から様々な生成AIツールを使い、実体験から得たリアルな知見も活かして執筆しています。